5つの頭脳。1つの意識。
前例のない認知システムは、5つの独立したコア・コンポーネントが相互に連携することで機能します。
R.E.V.I.S.
すべての思考とモジュールを統括する中枢オーケストレーター。ユーザーの意図を瞬時に解読してタスクを分配し、あらゆる認知プロセスの指揮を執ります。
自動スレッドルーティング
話題のドリフトを検知。過去の記憶を呼び起こすか、新しい思考空間を作るかを判断し、文脈の汚染を防ぎます。
無意識の記憶整理
バックグラウンドで情報の整理を行い、純粋な知識のみをベクトル化して記憶の奥底に定着させる高度なRAG機能です。
自己監査 Pro Edition
生成された回答を裏側で二重チェックし、矛盾があれば即座に訂正プロセスを走らせる高度な信頼機構です。*4
F.A.L.Q.
R.E.V.I.S.の神経系を支える高度なタスクキュー・システム。複数の推論タスクを優先度に基づいて整理・並列実行します。
優先度制御
ユーザーのアクションを最優先しながら、バックグラウンドの記憶整理や検証タスクをリソース状況に合わせて賢く処理します。
Agentic Workflow
複雑な課題を分解し、専用の推論処理を連鎖させることで、単一モデルの限界を突破した高度な論理展開を可能にします。*5
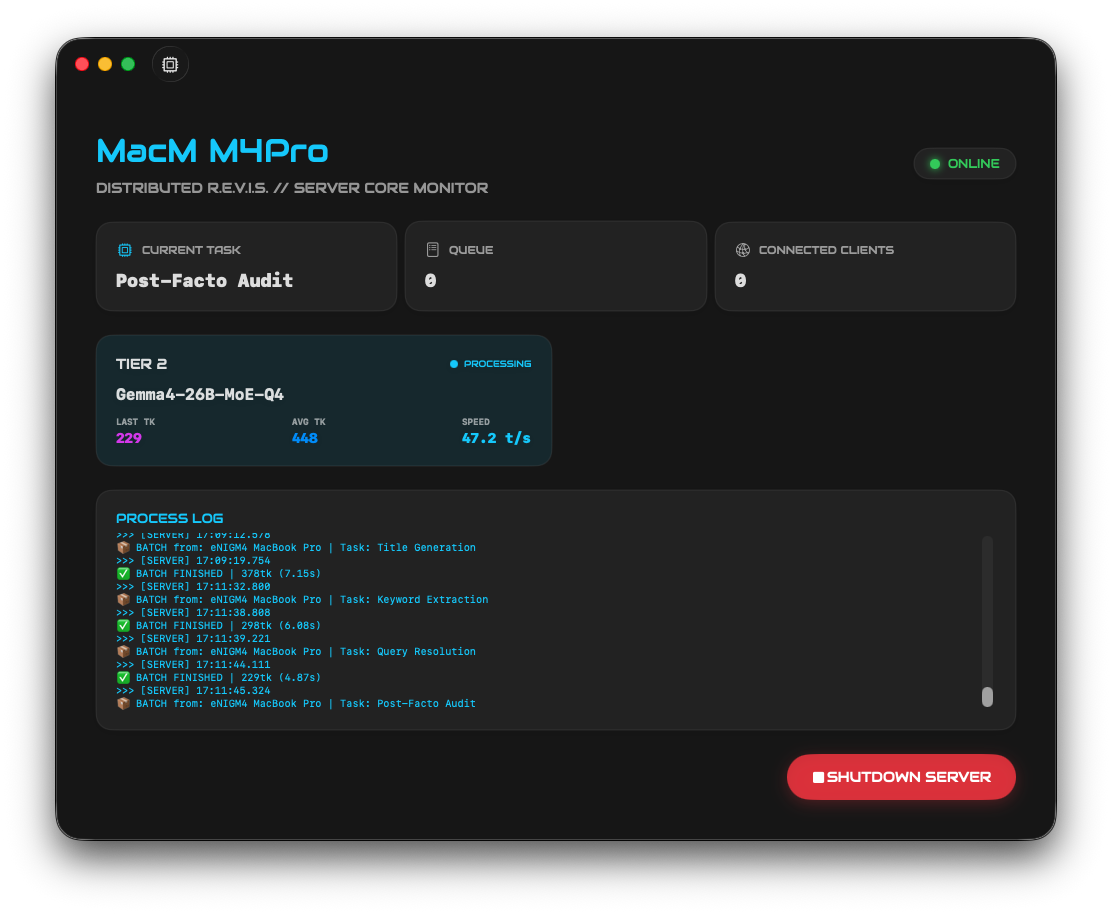
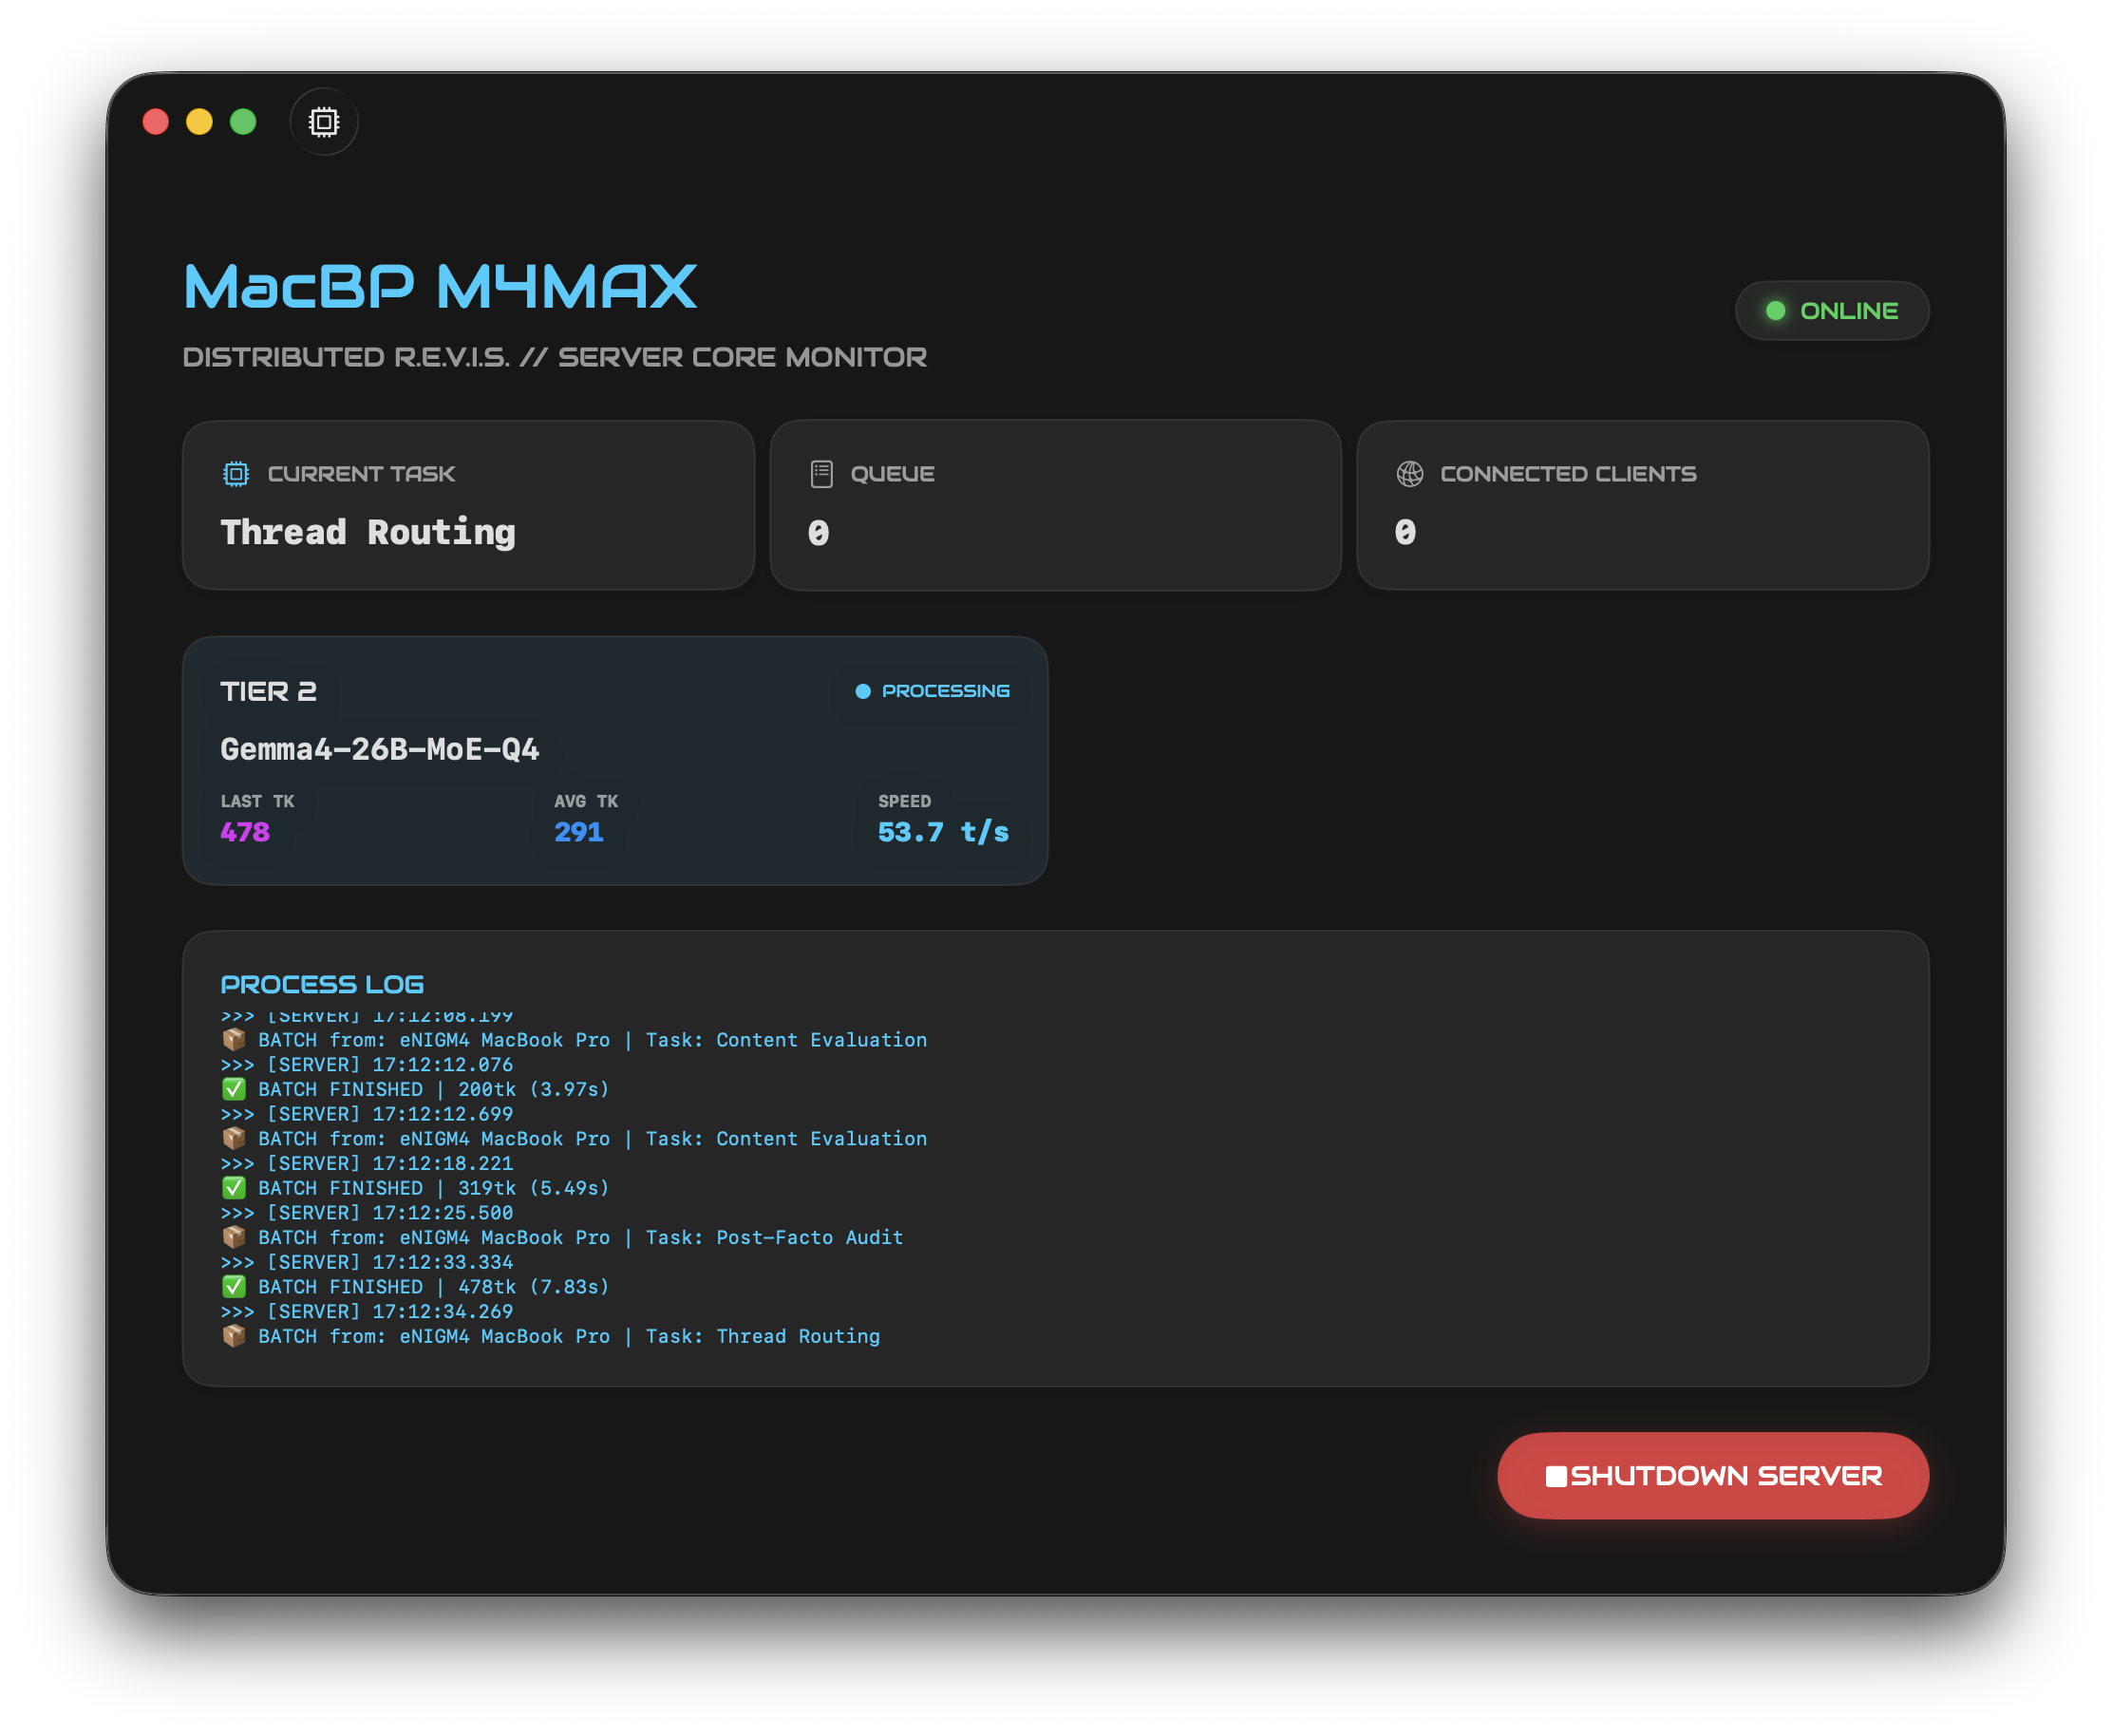
分散推論 Pro Edition
ローカルネットワーク上の複数のMacを連携。計算資源を統合し、エージェントの高速並列処理を実現します。
K.E.C.H.I.
独自の文脈抽出技術。膨大なデータから必要な「純粋な事実」だけを高速に取得し、AIの回答精度を飛躍的に向上させます。
Wikipedia接続
標準版では、世界最大級の信頼性を誇るWikipediaベースの知識を瞬時に引き出し、正確な情報を提供します。
一般WEB検索 Pro Edition
Pro版では一般Web全体へアクセス。最新のニュースや、より専門的でニッチな情報までを網羅します。
J.I.T.R.X.
ユーザーの入力に合わせてプロンプトを動的生成・最適化する高度なコンパイラ層です。
動的プロンプト生成
タスクの性質に応じて、AIに渡すシステムプロンプトをリアルタイムで構築し、最適な回答を引き出します。
トークン最適化
文脈を維持したまま消費トークンを極限まで圧縮し、高速かつ低負荷な推論を実現します。
M.μ.X.I.S. Pro Edition
あなたの代わりにR.E.V.I.S.を自律的に動かす「仮想ユーザー」的エージェント。ユーザーの待ち時間をゼロにするため、時間のかかるあらゆる処理を裏側で進行させます。
自律リサーチ
AIが自律的に「次に必要な知識」を予測して収集。次回の対話時に、より迅速で的確な回答を生成するための準備を整えます。
バックグラウンド調査
「〜について調べといて」と指示するだけ。時間のかかる調査を裏側で徹底的に行い、システムの記憶として静かに定着させます。
※今後のアップデートにより、さらに高度な自律タスクの実行機能が追加され、AIの「自立性」を極限まで高めます。*3